大規模LUTからの脱却
AMATERASSでは太陽放射を放射伝達モデルによって物理的に解析します。詳細な物理過程を衛星解析へ導入するためには、雲などの粒子や吸収ガス、地表面アルベドなど、多数の物理パラメータを扱う必要があります。
衛星リモートセンシングでは、放射伝達モデルによる計算結果をあらかじめルックアップテーブル(LUT)として保存し、観測時に参照する方法が広く用いられてきました。しかし、扱う物理パラメータが増えると、必要な組み合わせは急速に増加します。より詳細な物理過程を扱おうとするほどLUTは巨大になり、その生成・保存・検索・内挿も複雑になります。
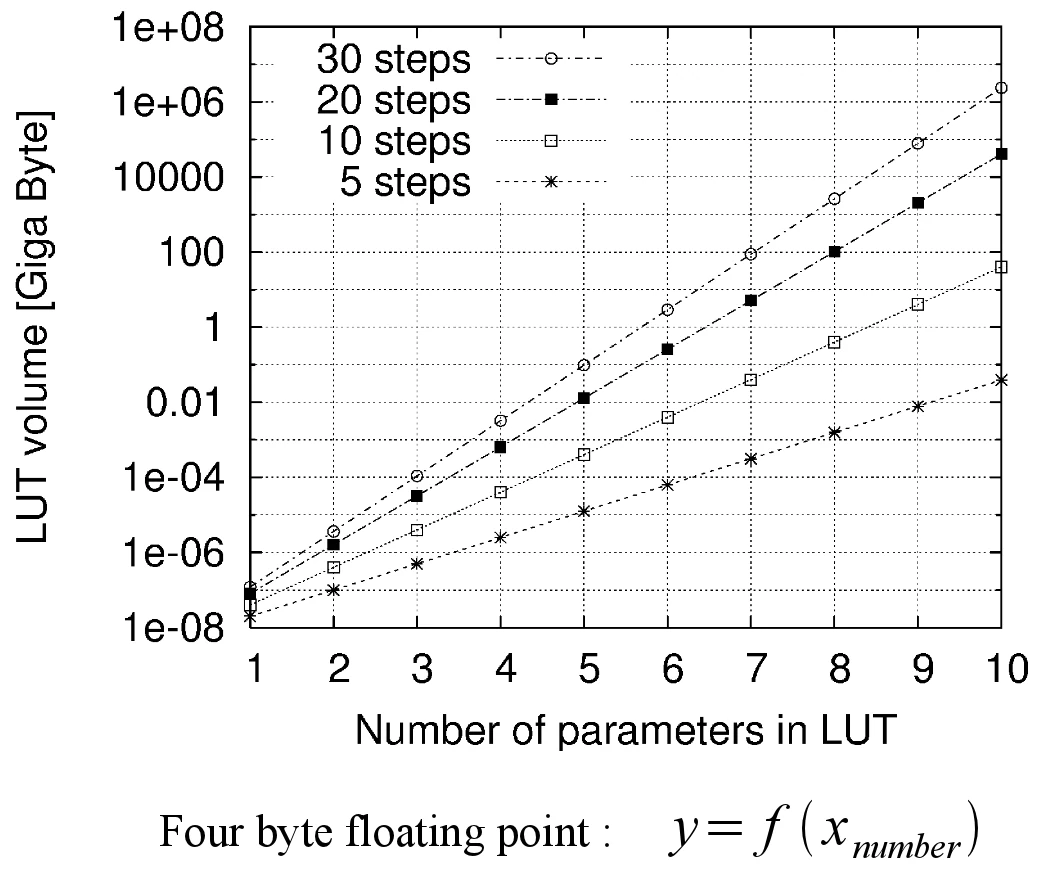
AMATERASSでは、この大規模LUTへの依存から脱却するため、放射伝達モデルの入出力関係そのものをニューラルネットワークに学習させる方法を開発しました。
LUT
あらかじめ計算した多数の組み合わせを保存し、解析時に検索・内挿して利用します。
- パラメータ数が増えるほど巨大化
- 保存・検索・内挿が複雑になる
- 多次元化で扱いが難しくなる
学習済みニューラルネットワーク
物理パラメータと放射量の関係を関数として保持し、高速なソルバーとして利用します。
- 大規模LUTに依存しない
- コンパクトな計算系として保持できる
- 高速な物理解析に向いている
物理解析のための学習アルゴリズム
ニューラルネットワークが学習するのは、衛星観測と地上観測との経験的な関係ではありません。入力となる雲などの粒子や吸収ガス、地表面アルベドなどの物理パラメータと、詳細な放射伝達モデルによって計算された放射量との関係です。
LUTがあらかじめ計算した離散的な値を保存して参照するのに対し、ニューラルネットワークは放射伝達モデルの入出力関係を連続的な関数として近似します。
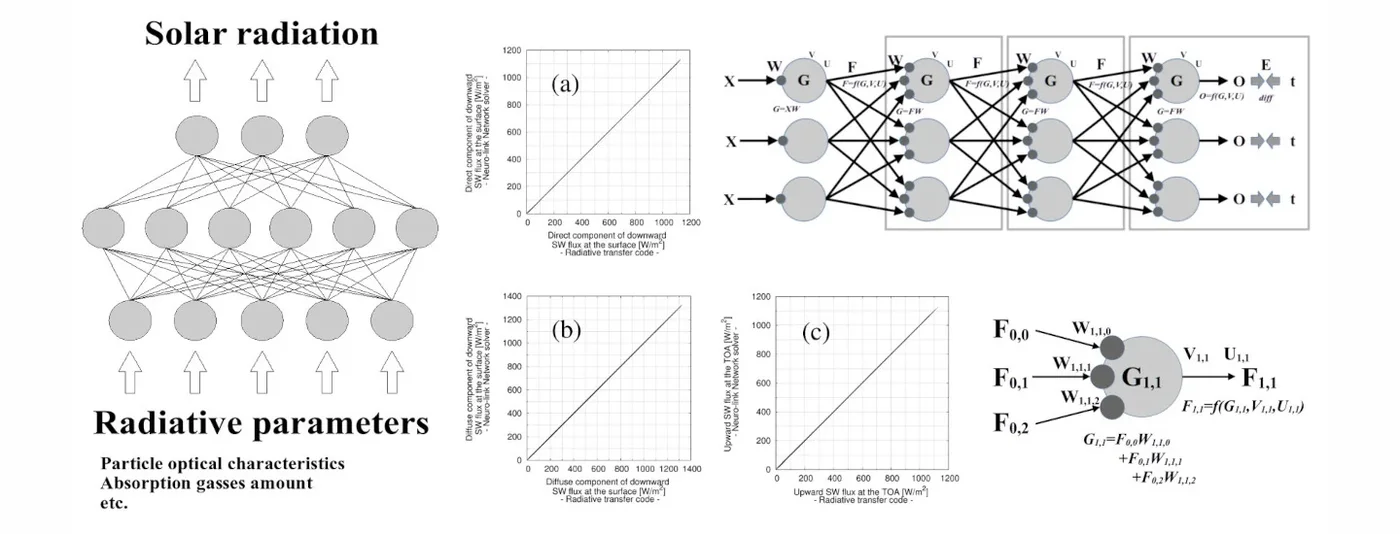
このためAMATERASSの開発では、単に既存のニューラルネットワークを利用するだけでなく、複雑な放射伝達計算を高精度に再現するための学習アルゴリズムも開発しました。
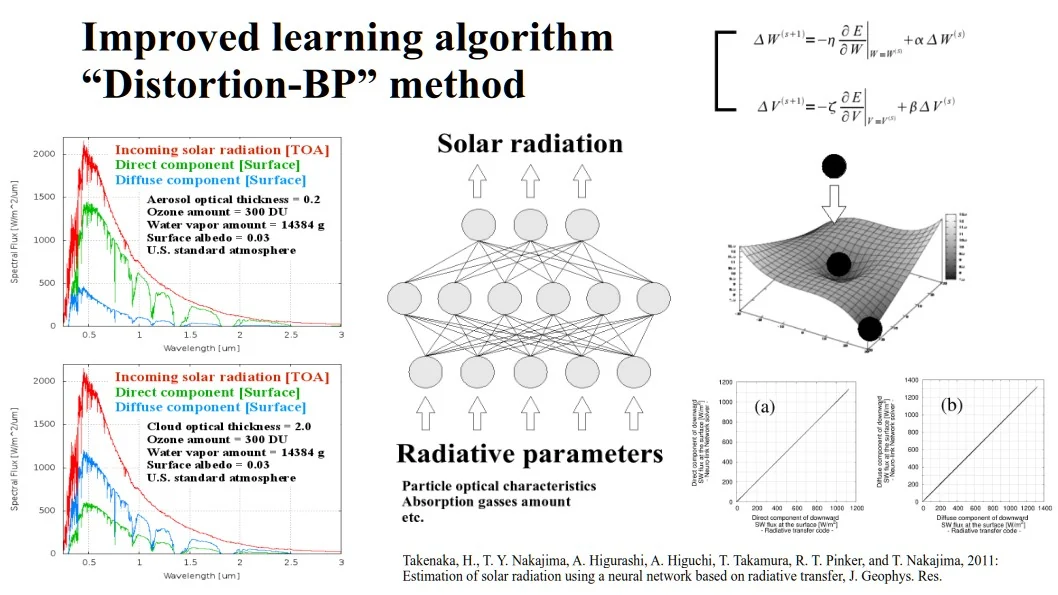
学習後のニューラルネットワークは、時間のかかる放射伝達計算を毎回実行する代わりに、その計算結果を高速に再現する放射伝達ソルバーとして機能します。現在の用語ではサロゲートモデルやエミュレータに近い考え方ですが、重要なのはニューラルネットワークを利用したこと自体ではありません。
物理計算を、衛星観測の速度へ
この方法には、もう一つ大きな利点がありました。計算速度です。AMATERASSの開発を始めた2005年当時、詳細な放射伝達計算による日射量解析は1ピクセルあたり数秒程度を要していました。 PCのCPUはまだシングルコアが中心であり、3000×3000ピクセル、つまり9,000,000ピクセル規模の衛星画像に物理モデルを直接適用すれば、解析には数日以上を要します。
一方、当時のひまわりは1時間ごとの全球観測と、その間を補う半球観測を行っていました。準リアルタイムで解析するためには、次の観測データが到着するより前に計算を終える必要があります。学習済みニューラルネットワークによって放射伝達モデルを再現する方法は、大規模LUTの問題を解決すると同時に、この計算速度の壁も取り除きました。
数日以上の計算を、数分へ
この技術により、放射伝達計算は飛躍的に高速化されました。
実際の衛星画像処理では、従来は数日以上を要した3000×3000ピクセル、すなわち900万ピクセル規模の解析を、数分程度で処理できるようになりました。
これによって、詳細な放射伝達モデルを用いた物理解析を、静止気象衛星の観測周期に追随して実行することが可能になりました。これは単なる処理時間の短縮ではありません。計算量の制約によって実用化が困難だった衛星全画素の物理解析を、継続的に運用できる解析システムへ変えたことを意味します。
大規模LUTからの脱却と計算の高速化。この二つを同時に実現したことが、AMATERASSによる準リアルタイム太陽放射解析を可能にしました。
なぜこれほど高速だったのか
高速化の理由は、ニューラルネットワークによって演算量を大幅に削減できたことだけではありません。
詳細な放射伝達モデルでは、多数の係数表や中間変数を参照しながら複雑な計算を進めます。そのため計算に必要なデータ全体をCPUキャッシュ内に保持することは難しく、メインメモリとのデータ転送が頻繁に発生します。当時のコンピュータではメモリ帯域も限られており、CPUコアを増やして並列化しても、複数のコアがメモリへの経路を共有することで、1コアあたりの実行性能が低下することがありました。
一方、学習済みニューラルネットワークは非常にコンパクトです。
詳細な放射伝達モデル
- 大きな係数表と中間変数
- 頻繁なメモリアクセス
- 並列化するとメモリ帯域を共有
学習済みニューラルネットワーク
- 小さな重みと計算コード
- CPUキャッシュ内に保持しやすい
- 入力を順番に読み、結果を書き出す
ネットワークの重みと計算部分をCPUキャッシュ内に保持できれば、メインメモリから入力パラメータを順番に読み込み、CPU内部で計算し、結果を書き出すという単純な処理になります。
この構造はCPUのキャッシュやプリフェッチ機構との相性がよく、その後CPUがデュアルコア、マルチコアへ発展すると、実効的な処理速度はさらに向上しました。計算量を減らしただけではなく、大量のデータ移動を必要とする計算から、CPU内部で完結しやすい計算へ変換したことも、大幅な高速化を生んだ重要な要因でした。
これは、演算性能だけでなくメモリとのデータ転送量が性能を左右する現代のGPUコンピューティングにも通じる考え方です。